Graph
Graph(中文通常翻譯為「圖」)是一種用來表示「物體」與「物體之間關係」的資料結構
這裡的「圖」不是指照片或圖片,而是一個像「網路」一樣的網狀結構。例如臉書上的好友關係、Google 地圖上的道路,都可以用 Graph 來表示。

想像臉書的好友動態牆:每一個人是一個點,每一段好友關係是一條線,整張社群網路本質上就是一張巨大的 Graph。
Graph 要解決的問題,通常就是「這些點跟點之間要怎麼連、怎麼走、怎麼算距離」。
組成要素
- 頂點 (Vertex / Node)
- 代表「物體」本身,例如一個人、一個城市或一個網頁
- 邊 (Edge)
- 代表點跟點之間的「關係」,也就是連接兩個頂點的線
- 例如兩個人是朋友、兩個城市之間有道路
常見種類
根據關係的不同,Graph 可以分成以下幾種:
- 無向圖 (Undirected Graph):線沒有方向,關係是雙向的。
- 例子:臉書的好友關係。你對他是好友,他對你也就自然是好友。
- 有向圖 (Directed Graph):線有箭頭,代表單向關係。
- 例子:IG 的追蹤。你可以追蹤某個明星,但明星不一定會追蹤你。
- 權重圖 (Weighted Graph):每條線上都有一個權重,可代表距離、成本或時間。
- 例子:地圖導航。城市之間的連線會寫上「開車需要 30 分鐘」或「距離 15 公里」。
- 有向無環圖 (DAG, Directed Acyclic Graph):有方向、但不會走回頭路形成環的 Graph。
- 例子:大學課程的先修規定。這類 Graph 通常會搭配 Topological Sort 排出合法的執行順序。
儲存 Graph 的方式
電腦沒辦法直接看懂畫出來的圖,所以常用以下兩種方法把 Graph 存進記憶體裡:
- Adjacency Matrix
- Adjacency List
鄰接矩陣 (Adjacency Matrix)
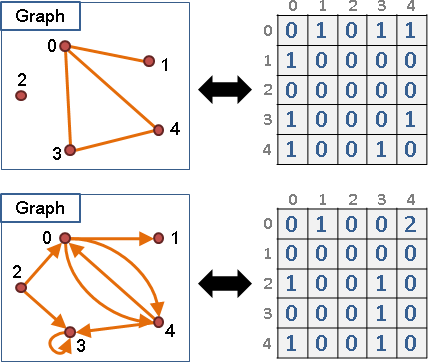
用一個二維的格子(表格)來記錄。
如果點 A 和點 B 有連線,就在格子交界處記為 1(或是寫上權重),沒連線就記為 0。
- 優點:想要查「點 A 和點 B 有沒有連線」非常快。
- 缺點:如果點很多、但線很少,會浪費很多格子空間存 0。
鄰接串列 (Adjacency List)
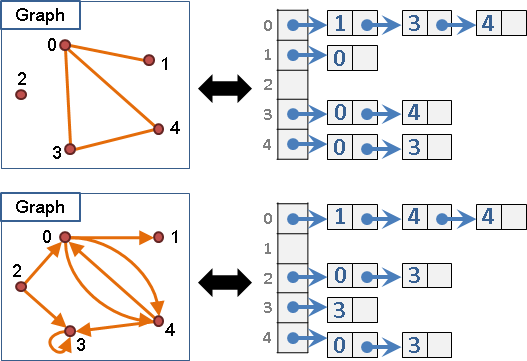
每一個頂點自己拿一張清單,只列出跟自己有連線的其他頂點。
- 優點:非常省空間,有幾條線就用多少空間。
- 缺點:想要查特定的兩點有沒有連線,必須要把清單從頭到尾遍歷過。
比較
| 操作 / 空間 | Adjacency Matrix | Adjacency List | 贏家 |
|---|---|---|---|
| 空間複雜度 (記憶體容量) | O(V^2) | O(V + E) | Adjacency List (省空間) |
| 加入新頂點 (Add Vertex) | O(V^2) | O(1) | Adjacency List (速度快) |
| 加入新邊 (Add Edge) | O(1) | O(1) | 平手 |
| 刪除頂點 (Remove Vertex) | O(V^2) | O(V + E) | Adjacency List (速度快) |
| 刪除邊 (Remove Edge) | O(1) | O(U) | Adjacency Matrix (速度快) |
| 查詢兩點是否有連線 | O(1) | O(U) | Adjacency Matrix (速度快) |
- V:頂點 (Vertex / Node) 的總數
- E:邊 (Edge) 的總數
- U:與該點相連的邊的數量,一個點可能跟所有點相連,所以最多是 Vertex 的總數 (V)
| ADJACENCY LIST | ADJACENCY MATRIX | |
|---|---|---|
| 稀疏圖 (Sparse Graph) | 適合 | 耗費空間 |
| 迭代 edges | 快 | 慢 |
| 找特定 edge | 慢 | 快 |
真實應用情境下 Sparse Graph 比較常見,所以多數情況會比較適合用 Adjacency List,在刷題時一般也都是用 Adjacency List。
實作
Undirected Graph
實作 Undirected 同時也是 Unweighted 的 Graph:
- Python
- JavaScript
- Java
class Graph:
    def __init__(self):
        self.adjacency_list = {}

    def add_vertex(self, vertex):
        if vertex in self.adjacency_list:
            return  # 已經存在就不需要再次加入
        self.adjacency_list[vertex] = []

    def add_edge(self, v1, v2):
        self.adjacency_list[v1].append(v2)
        self.adjacency_list[v2].append(v1)

    def remove_edge(self, v1, v2):
        self.adjacency_list[v1] = [v for v in self.adjacency_list[v1] if v != v2]
        self.adjacency_list[v2] = [v for v in self.adjacency_list[v2] if v != v1]

    def remove_vertex(self, vertex):
        lst = self.adjacency_list.get(vertex)
        if lst is None:
            return None
        for v2 in list(lst):
            self.remove_edge(vertex, v2)  # 每個和 vertex 相連的都斷開連結
        del self.adjacency_list[vertex]
class Graph {
  constructor() {
    this.adjacencyList = {};
  }

  addVertex(vertex) {
    if (this.adjacencyList[vertex]) return; // 已經存在就不需要再次加入
    this.adjacencyList[vertex] = [];
  }

  addEdge(v1, v2) {
    this.adjacencyList[v1].push(v2);
    this.adjacencyList[v2].push(v1);
  }

  removeEdge(v1, v2) {
    this.adjacencyList[v1] = this.adjacencyList[v1].filter(
      (vertex) => vertex !== v2
    );
    this.adjacencyList[v2] = this.adjacencyList[v2].filter(
      (vertex) => vertex !== v1
    );
  }

  removeVertex(vertex) {
    const list = this.adjacencyList[vertex];
    if (!list) return undefined;
    list.forEach((v2) => {
      this.removeEdge(vertex, v2);  // 每個和 vertex 相連的都斷開連結
    })
    delete this.adjacencyList[vertex];
  }
}
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

class Graph {
    private Map<String, List<String>> adjacencyList;

    public Graph() {
        this.adjacencyList = new HashMap<>();
    }

    public void addVertex(String vertex) {
        if (this.adjacencyList.containsKey(vertex)) return; // 已經存在就不需要再次加入
        this.adjacencyList.put(vertex, new ArrayList<>());
    }

    public void addEdge(String v1, String v2) {
        this.adjacencyList.get(v1).add(v2);
        this.adjacencyList.get(v2).add(v1);
    }

    public void removeEdge(String v1, String v2) {
        this.adjacencyList.get(v1).removeIf(vertex -> vertex.equals(v2));
        this.adjacencyList.get(v2).removeIf(vertex -> vertex.equals(v1));
    }

    public void removeVertex(String vertex) {
        List<String> list = this.adjacencyList.get(vertex);
        if (list == null) return;
        for (String v2 : new ArrayList<>(list)) {
            this.removeEdge(vertex, v2); // 每個和 vertex 相連的都斷開連結
        }
        this.adjacencyList.remove(vertex);
    }
}
在解題的時候,比較常見的做法是只在 function sol 裡面定義 list 作為 Graph 的起點,利用物件導向另外定義物件比較費時。
遍歷 Graph 的演算法,寫在 Graph Traversal 裡,歡迎前去參考。
Weighted Graph
和 Undirected Graph 差不多,只是在 edge 加上權重而已:
- Python
- JavaScript
- Java
class WeightedGraph:
    def __init__(self):
        self.adjacency_list = {}

    def add_vertex(self, vertex):
        if vertex not in self.adjacency_list:
            self.adjacency_list[vertex] = []

    def add_edge(self, v1, v2, weight):
        self.adjacency_list[v1].append({"node": v2, "weight": weight})
        self.adjacency_list[v2].append({"node": v1, "weight": weight})

    # 其他 method 皆相同
class WeightedGraph {
  constructor() {
    this.adjacencyList = {};
  }

  addVertex(vertex) {
    if (!this.adjacencyList[vertex]) this.adjacencyList[vertex] = [];
  }

  addEdge(v1, v2, weight) {
    this.adjacencyList[v1].push({ node: v2, weight });
    this.adjacencyList[v2].push({ node: v1, weight });
  }

  // 其他 method 皆相同
}
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

class WeightedGraph {
    private static class Edge {
        String node;
        int weight;

        Edge(String node, int weight) {
            this.node = node;
            this.weight = weight;
        }
    }

    private Map<String, List<Edge>> adjacencyList;

    public WeightedGraph() {
        this.adjacencyList = new HashMap<>();
    }

    public void addVertex(String vertex) {
        if (!this.adjacencyList.containsKey(vertex)) {
            this.adjacencyList.put(vertex, new ArrayList<>());
        }
    }

    public void addEdge(String v1, String v2, int weight) {
        this.adjacencyList.get(v1).add(new Edge(v2, weight));
        this.adjacencyList.get(v2).add(new Edge(v1, weight));
    }

    // 其他 method 皆相同
}
但 Weighted Graph 的重點會放在搜尋兩個點之間的最短路徑,也就是 Shortest Path Problem 上,較常見的做法是 Dijkstra's Algorithm(單一起點)或 Floyd-Warshall's Algorithm(所有點對所有點)。
適用情況
- 社群網路:使用者是頂點,好友或追蹤關係是邊,用來分析人際連結、推薦好友。
- 地圖導航與路網規劃:地點是頂點,道路是邊(通常帶權重),用來規劃路線或計算最短距離。
- 網頁連結結構:網頁是頂點,超連結是邊(有向圖),例如搜尋引擎用來評估網頁重要性。
- 任務 / 課程的依賴關係:只要關係中存在「先後順序」,通常會建成 DAG,再搭配 Topological Sort 排出合法順序。
判斷連通性的另一個選擇:Union Find
如果題目只在乎「兩個節點是否連通」、「總共有幾群互不相連的節點」,而不需要知道實際路徑,Union Find 通常會比每次都重新做一次 Graph Traversal 更方便,尤其是當連線關係會動態增加的時候。
常見誤區
- 忘記處理已拜訪過的節點:Graph 允許出現環(Cycle),如果走訪時沒有用 visited 集合記錄「哪些點已經去過」,程式很容易陷入無窮迴圈,可參考 Graph Traversal。
- 無向圖只加了單邊:Undirected Graph 代表 A 到 B、B 到 A 都能通,實作
addEdge時必須同時在 A 和 B 兩邊的清單裡都加上對方,忘記其中一邊就會變成有向圖,導致走訪結果不對。 - 誤用 Adjacency Matrix 處理稀疏圖(Sparse Graph):現實世界大多數的 Graph 點多、線少(例如社群網路好友關係),如果全部都用 O(V^2) 的 Matrix 儲存,會浪費大量記憶體去存一堆沒有連線的 0,這種情況通常用 Adjacency List 更划算。