系統設計系列文20:Feed 走向大型系統的 Fan-out 做法
· 閱讀時間約 5 分鐘

今天回頭加強 Feed 功能,看看原本陽春的做法會有什麼問題。
從需求拆解到架構設計、擴展與維運
檢視所有標籤今天回頭加強 Feed 功能,看看原本陽春的做法會有什麼問題。
昨天把 Database 拆成多個 Shard,解決了單一 Database 裝不下所有資料的問題。
今天把這個概念套用在一個具體場景上——Follow 功能,順便討論「業界到底怎麼做 Follow」,包含資料庫怎麼選、常見的演算法有哪些。
Day 17 用 CAP Theorem 收尾時提到一句話:這條線會一路貫穿到後面 Sharding、Counter System 這些主題。今天就從 Sharding 開始。
回顧一下 Day 7 做的事:把一個 Database 拆成 Primary 跟多個 Read Replica。
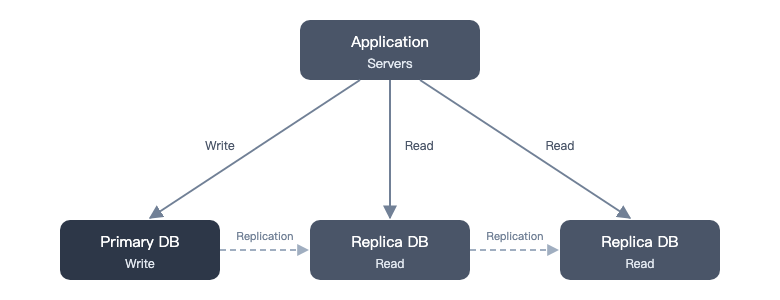
當時特別澄清過一件事:這樣做還稱不上 Database 的 Horizontal Scaling,因為每個 Replica 裡面裝的都是同一份完整資料。
這代表兩件事還是沒解決:
Replication 解決的是「太多人同時讀」,但沒解決「資料量太大、寫入太多」,這是 Sharding 要處理的問題。
昨天討論 SQL 該不該換成 NoSQL,最後留下一個疑問,一旦資料開始分散在不同種類的 Storage 上,SQL、NoSQL、Cache 各存一部分。
怎麼確保各處看到的資料是一致的?
現在狀況只會比 Day 7 那種單純的 Primary/Replica 架構更複雜,其實這個問題在當時就已經埋下種子了。當時我們用 Database Replication 解決 Read Scaling:
留下一個沒細講的伏筆——Replication Lag:Squirtle 剛發的文章,可能要過一小段時間才會出現在某些 Replica 上。
如果只是「晚一點看到自己剛發的文章」,問題還不算太嚴重。但如果今天不是 Replica 同步慢了半拍,而是 Primary 跟 Replica 之間的網路直接斷線呢?系統這時候該怎麼辦?
不管是 Replica 之間、還是 SQL 與 NoSQL 之間,只要資料存在多個地方,就一定會遇到這個問題。這就是分散式系統裡一個非常經典的理論:CAP Theorem。
PokeThreads 走到今天,已經不是一個單純的 CRUD 小玩具了,但從 Day 2 開始,Database 一直都是同一種選擇,也就是 SQL。這時候很自然會冒出一個問題:
系統都長這麼大了,是不是該把 SQL 換成 NoSQL?
甚至有人會直接跳到結論:「大型系統不都應該用 NoSQL 嗎?」
今天就來仔細了解這個問題。
昨天在 API Gateway 的職責清單裡,提到它很適合順便做 Rate Limiting,但只是輕輕帶過。今天把這件事攤開來講清楚。
昨天把 Notification 從 PokeThreads 的 Monolith 拆成了獨立的 Notification Service,跟原本的 API Service 之間用 gRPC 溝通:
API Service ⇄ gRPC ⇄ Notification Service
拆完第一個 Service 之後,接下來這個趨勢大概不會停在這裡。假設之後 Search、Media Processing 也陸續被拆成獨立 Service,Client(瀏覽器、App)要面對的後端,就從「一個 Application」變成「一群 Service」:
如果讓 Client 直接記住每個 Service 的位址、各自打各自的 API,那還沒扯到功能,光是「知道要打誰」這件事,就已經讓前端變得很脆弱。
任何一個 Service 的位址一旦改變,所有 Client 都要跟著改。而且如果每個 Service 都要各自驗證使用者身份,Authentication 邏輯就會重複散落在每個 Service 裡。
到目前為止,PokeThreads 已經具備了 Load Balancer、Read Replica、Cache、Stateless Server、CDN 與 Message Queue,是時候回頭想想,這些元件之間該怎麼有效率地互相溝通了。
不過在談溝通方式之前,先看一眼現在的 Application Server 到底裝了多少東西。
昨天做出了最陽春的 Notification System,採用最直接的同步方式:
Charmander -> POST /posts/:id/like -> Create Like -> Create Notification -> Response
這種方式在系統規模小的時候很合理,但功能一多,API 要做的事情就跟著變多。
假設之後除了 Notification,還要加上 Analytics(資料分析),如果所有事情都得在同一個 Request 裡做完才能回應,這支 API 只會越來越慢。
解法是把「不需要讓使用者等待結果」的工作,從同步流程裡抽出去,變成背景作業,這就要靠 Message Queue (MQ)。
前面幾天,PokeThreads 的架構已經慢慢演化成分散式系統,不過所有功能都還圍繞在「發文、讀文」上。
只有這麼簡單的功能,實在太像古早時期的社群網站,今天要加入一個現代社群平台幾乎必備的功能:Notification(通知)。
情境很簡單:Pikachu 發了一篇貼文,Charmander 看到之後按下 Like,Pikachu 應該要收到一則「Charmander liked your post」的通知。