系統設計系列文22:深入探討 Search System

我們的 PokeThreads 走到現在,已經是一個具備 Load Balancer、Stateless Server、Sharded Database、Cache、CDN、Message Queue 的系統了,但有一個使用者天天在用、我們卻從來沒認真設計過的功能:搜尋。
Pikachu 想找某篇提到「寶可夢」的貼文,或是想直接搜尋 Charmander 這個帳號,這種需求聽起來理所當然,但要做好一點都不簡單。
最直覺的做法:SQL 查詢
先看最陽春的寫法:
SELECT *
FROM posts
WHERE content LIKE '%寶可夢%';
看起來簡單又完全合理,反正資料都在 Database 裡,查一下不就好了?
在資料量很小的時候,這樣寫確實沒問題,但隨著 PokeThreads 一路走到今天的規模,這支 Query 會出大問題。
為什麼 LIKE 查詢撐不住
索引救不了前後都有萬用字元的查詢
Database 的 Index(索引)本質上是排序過的資料結構,適合用來加速「等於」「範圍」「前綴比對」這類查詢,例如 WHERE content LIKE '寶可夢%'(只有結尾是萬用字元)還可能用得上索引。
但 LIKE '%寶可夢%' 這種前面也有萬用字元的寫法,Database 沒辦法用索引快速定位起點,只能整張表逐筆比對,這就是 Full Table Scan(全表掃描)。
Sharding 後問題被放大
回想 Day 18 我們把 Posts 表 Sharding 成好幾個獨立的 Database Node,這對一般依照 Shard Key 查詢的操作很有幫助,但對「搜尋」這種需求完全是反效果,因為我們不知道符合關鍵字的貼文分散在哪些 Shard,只能對每一個 Shard 都做一次 Full Table Scan,再把結果合併起來。
Shard 越多,一次搜尋要付出的代價反而越高。
本來就不是為了「搜尋」而生
就算不考慮效能,LIKE 查詢在語意上也做不到真正的搜尋引擎會做的事:
- 沒辦法按照「相關程度」排序結果
- 沒辦法處理同義詞、模糊比對、錯字容錯
- 沒辦法做斷詞(例如把「寶可夢訓練家」拆成「寶可夢」「訓練家」分別比對)
換個角度:Inverted Index
真正的搜尋引擎不會每次現場掃描全部文件,而是預先建立一份反過來的索引。
一般的資料表是「每一列存一篇文章」,而 Inverted Index 反過來,是「每一個字,對應一份出現過這個字的文章清單」:
一般索引:Post ID -> 文章內容

Inverted Index:
"寶可夢" -> [Post 1, Post 5, Post 42, ...]
"訓練家" -> [Post 5, Post 9, ...]
"神奇"   -> [Post 3, Post 42, ...]
當使用者搜尋「寶可夢」,系統不需要掃過所有文章,只要直接去 Inverted Index 查「寶可夢」對應的清單,就能立刻拿到候選結果,這個查詢複雜度跟資料總量幾乎無關,只跟這個字出現的次數有關。
AI 如何補上關鍵字搜尋的盲點
前面提到,LIKE 查詢有個天生的限制:沒辦法處理同義詞、模糊比對。
Inverted Index 解決的是效能問題,但這個語意上的限制其實還在,如果 Pikachu 搜尋「跑得很快的寶可夢」,貼文裡寫的卻是「敏捷」「速度型」,關鍵字比對完全抓不到這種意思相近、字面卻不同的內容。
這正是這幾年業界普遍導入 AI 的地方:把每一篇貼文丟給一個 Embedding Model,轉換成一組能代表「語意」的向量(Vector),意思相近的內容,向量在空間中的距離也會相近。搜尋時把使用者輸入的關鍵字也轉成向量,直接找出向量空間裡最接近的貼文,這種做法叫 Semantic Search(語意搜尋),也稱 Vector Search。
實務上很少整個換掉 Inverted Index,而是兩者混用,稱為 Hybrid Search:關鍵字比對負責精準比對(例如帳號名稱、Hashtag 這類需要完全命中的內容),Vector Search 負責語意相關的內容,兩邊的結果再一起排序合併。
資料怎麼進到 Search Index?
選項一:發文時同步寫進
這代表 POST /posts 除了寫 Database,還要多等 Search Index 也寫入成功才能回應,等於在寫入路徑上多綁了一個依賴。
如果 Search Index 那端變慢或暫時掛掉,連帶拖累使用者發文這個核心操作,這正是 Day 11 我們在同步 Notification 上踩過的坑。
選項二:透過 Message Queue 非同步更新
這才是實務上更常見的做法:
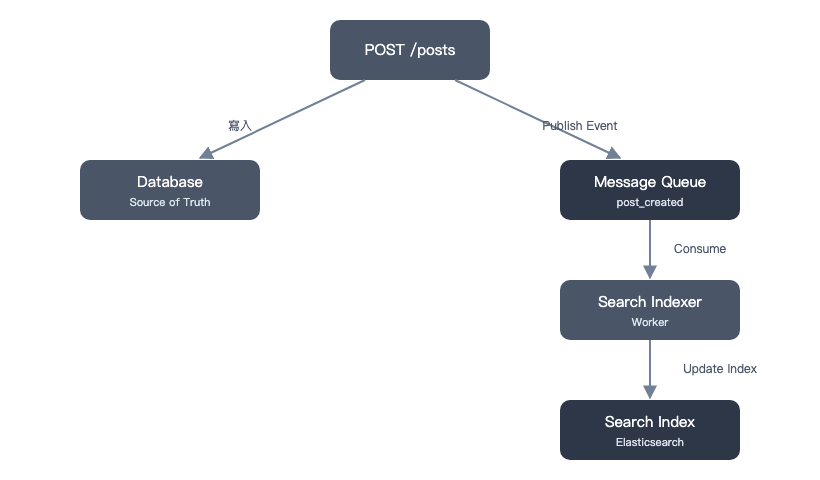
發文流程維持原本的樣子,Database 依然是 Source of Truth,額外多發布一個 post_created 事件到 Message Queue,由一個獨立的 Search Indexer Worker 消費這個事件,把新貼文的內容寫進 Search Index。
Trade-off:搜尋結果可能慢半拍
把索引更新變成非同步之後,會有一段時間差:Pikachu 剛發的文章,可能要過幾百毫秒甚至幾秒鐘,才會真正出現在搜尋結果裡。
這其實就是 Day 17 談過的 Eventual Consistency,Search Index 不追求跟 Database 完全即時同步,而是接受「最終會同步」這件事。
對搜尋功能來說,這個延遲通常完全可以接受:沒有人會期待自己剛發的文章,一秒鐘內就出現在全站搜尋結果的第一名。
索引跟資料庫兜不起來時,怎麼辦?
非同步更新換來的不只是延遲,還有一個更麻煩的問題:Message Queue 的訊息漏送、重複送,或是文章被刪除的時候,Search Index 該怎麼補救?這幾個問題背後其實都是同一個原因——Message Queue 大多是 at-least-once(至少送達一次,而不是「剛好一次」)的語意延伸出來的。
漏事件:訊息真的不會憑空消失嗎?
Search Indexer Worker 一定要等「寫進 Search Index 成功」才對 Message Queue 回報 ack,中途處理到一半掛掉的話,這則訊息會被重新派送,不會真的遺失。
如果同一則事件重試了很多次還是處理失敗(例如索引服務本身出了 Bug),就讓它進 Dead Letter Queue,另外監控 DLQ 的堆積量,讓工程師事後排查,而不是讓失敗的事件無聲無息地消失。
重複事件:Idempotent 是唯一解
At-least-once 保證的是「至少送達一次」,重複本來就是預期內的事,重點是讓 Search Indexer Worker 的寫入動作天生冪等(Idempotent):Search Index 裡的 document ID 直接用 post_id,同一篇文章的事件不管重放幾次,都只是覆寫同一個 document,不會產生重複的搜尋結果。
還有一種狀況是事件抵達的順序亂掉,例如 Pikachu 剛發布文章,馬上發現打錯字又更新了一次,如果「更新」的事件比「發布」的事件早被處理完,反而會被舊資料蓋過去。解法是在事件裡帶一個遞增的版本號(或 updated_at),寫入前先比對版本,只有比目前記錄新的事件才允許覆蓋。
文章刪除:不能只靠定期 Reindex
刪除是最容易被低估的一塊。跟新增、更新一樣,刪除也應該走同一套非同步事件機制:發布一個 post_deleted 事件,Search Indexer Worker 收到後立刻把對應的 document 從 Search Index 移除(軟刪除的話,也可以只標記 is_deleted,查詢時用 filter 排除)。
定期 Reindex:最後一道防線
不管前面的補償機制設計得多仔細,非同步系統長期運行下來一定會累積一些 Drift(例如某次 Worker 部署時漏處理了幾筆事件、或 DLQ 裡的訊息遲遲沒人處理)。
實務上會定期(例如挑每天或每週的離峰時段)直接照 Database 目前的真實狀態,整批重建一份全新的 Search Index,並用版本號區分(例如 posts_v2),等新索引建好、資料驗證沒問題後,再把查詢用的 Alias 從 posts_v1 切到 posts_v2,整個過程對使用者來說是無感的。
這個全量重建還有一個附帶好處:因為是照 Database 現狀重新生成,Database 裡已經不存在的文章,自然不會出現在新的索引裡,順便清掉了殘留的幽靈文章。
補償機制(重試、DLQ、Idempotent 寫入)處理的是「讓系統盡快自己修好」;定期 Reindex 處理的是「萬一補償也沒接住,還有一個保底機制會把狀態拉回一致」。兩層疊在一起,Day 17 提過的 Eventual Consistency 才會真的「Eventual」,而不是無限期地拖著不管。
小結
搜尋看起來只是加一個搜尋框,但背後其實是完全不同的資料結構與查詢方式:
- SQL LIKE 查詢
- Full Table Scan,Sharding 後更糟
- Inverted Index
- 字 -> 文件清單,查詢與資料量脫鉤
- Vector Search
- 向量距離找語意相近的內容,補上關鍵字比對的盲點
PokeThreads 現在多了一條資料流:Database 負責寫入與讀取真相,Search Index 透過 Message Queue 非同步更新、專門負責回答「哪些文章符合這個關鍵字」。
而維持這條資料流的正確性,靠的是兩層保障:Idempotent 寫入、DLQ 搭配重試處理漏事件與重複事件;定期全量 Reindex 當最後一道防線,清掉補償機制也沒接住的 Drift。
這也再次印證一件事:不是所有查詢需求都該塞給同一個 Database 解決,該用什麼工具取決於問題本身。
系列導覽
- 查看全系列:系統設計系列文總覽