系統設計系列文19:深入探討 Follow 功能

昨天把 Database 拆成多個 Shard,解決了單一 Database 裝不下所有資料的問題。
今天把這個概念套用在一個具體場景上——Follow 功能,順便討論「業界到底怎麼做 Follow」,包含資料庫怎麼選、常見的演算法有哪些。
原本只能算 MVP
回想 Day 2,Follow 資料表只有三個欄位:
- Follow
- id:BIGINT(Primary Key)
- follower:BIGINT(Foreign Key → User.id)
- followee:BIGINT(Foreign Key → User.id)
這樣的設計在使用者不多時完全沒問題,但那只是最陽春的 MVP,撐不住社群網路的真實規模。
問題出在哪:兩種查詢方向會打架
假設老川爆紅,追蹤者衝到幾千萬人,這時候常見的查詢有三種:
Pikachu 追蹤了誰?         → 查 follower = Pikachu
誰追蹤了老川?              → 查 followee = 老川
Pikachu 有沒有追蹤老川?    → 查 follower = Pikachu AND followee = 老川
Day 18 教我們把 Follow 表 Sharding,但不管用 follower 還是 followee 當 Shard Key,都只能讓其中一個方向變快:
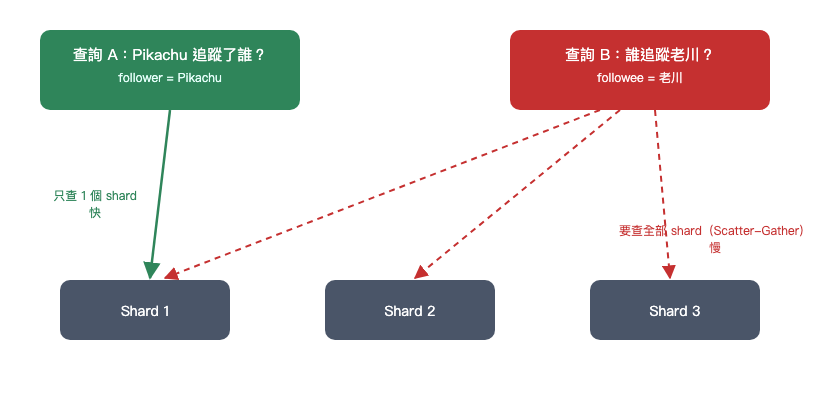
用 follower 切,查「Pikachu 追蹤了誰」只要問一個 Shard;但查「誰追蹤 老川」得問每一個 Shard 再合併結果,這叫 Scatter-Gather,非常費時。反過來用 followee 切也一樣,只是情況相反。
單靠 SQL 加 Sharding 解決不了這個兩難,因此業界在做 Follow 這個功能,通常不會只靠一種資料庫。
Follow 系統的資料庫
中大型社群平台的 Follow 系統,通常是好幾種資料庫分工:
1. 關聯式資料庫 (RDBMS) — 儲存核心關係
- 適用場景:儲存最基礎的「追蹤者與被追蹤者」關聯表。
- 優缺點:
- 優點:具備強大的 ACID 特性,保證「追蹤」這個動作的正確性
- 缺點:當資料量達到數億等級時,複雜的
JOIN操作或大規模查詢會導致效能嚴重下滑,必須依賴 Sharding
2. 鍵值與快取資料庫 (Key-Value / Cache)
- 適用場景:
- 快取使用者的「追蹤名單」或「粉絲名單」(通常使用 Redis 的 Set 或 Sorted Set 結構)。
- 優缺點:
- 優點:讀寫速度極快(微秒等級),能扛住社群平台每秒數十萬次的查詢
- 缺點:資料存在記憶體中,成本較高且不適合做為唯一的永久儲存媒介
3. 圖形資料庫 (Graph Database)
- 適用場景:專門用來處理「二度關係」、「三度關係」或「共同好友推薦」(例如推薦你「朋友的朋友」)。
- 優缺點:
- 優點:原生就是為了「節點(使用者)」與「邊(追蹤關係)」設計,查詢 Social Graph 的效能遠超傳統 SQL
- 缺點:不適合用來處理大量常規的資料寫入,通常做為輔助推薦系統的次要資料庫
4. 寬列/分散式資料庫 (Wide-Column / NoSQL)
- 適用場景:像 Twitter (X) 或 Instagram 這類頂級規模的平台,需要儲存萬億級別的動態(Feed)與追蹤關聯。
- 優缺點:
- 優點:寫入效能極高,支援無限制的 Horizontal Scaling,沒有 SPOF(Single Point of Failure)問題
- 缺點:採用 Eventual Consistency,可能發生「我剛點追蹤,重新整理卻還沒顯示」的微小延遲。
業界做法
中大型社群平台的標準做法通常是:
- 使用 MySQL / PostgreSQL 作為單一事實來源(Source of Truth),確保追蹤資料不遺失
- 前端查詢時,一律由 Redis 提供 Cache 後的
follower/followee列表,以達到極速回應 - 利用非同步處理將數據更新到 Graph Database 進行好友推薦計算
這種混搭策略有個名字,叫 Polyglot Persistence,前面 Day 16 也有提到過。
綜合考量規模與需求後,我們的 PokeThreads 正式採用 SQL + Redis + Graph Database 三件套:
- SQL 顧正確性
- Redis 扛前線的即時查詢
- Graph Database 負責「共同好友」「你可能認識的人」這類深度關係運算
Wide-Column Store 則是到 Twitter、Instagram 那種等級時,才需要認真考慮的選項。
常見的演算法
雙向索引:解決 Scatter-Gather
如同前面提到的,善用 Cache 在 Redis 額外維護資料,這兩份清單各自用一個 Redis Set 儲存:
followers:{user_id}  → 誰追蹤了這個人
following:{user_id}  → 這個人追蹤了誰
實際建立資料的時候,Pikachu 追蹤 Charmander 這個動作,會同時觸發兩筆 Set 寫入:
SADD following:Pikachu   Charmander    # Pikachu 追蹤的人多了 Charmander
SADD followers:Charmander Pikachu      # Charmander 的粉絲多了 Pikachu
取消追蹤則是相反的操作,把兩邊的紀錄一起刪掉。
寫入時同時更新兩份資料,查詢時就能直接從對應的結構拿結果,不需要再次進行複雜的查表作業。
共同好友:Set 交集運算
「Pikachu 和 Charmander 有哪些共同好友」這種問題,如果 following:{user_id} 存的是 Redis Set,答案就是取兩個 Set 的交集:
SINTER following:Pikachu following:Charmander
Redis 原生支援 Set 交集運算,不需要自己寫迴圈比對,這也是 Redis 常被拿來實作「共同關注」功能的原因。
深度關係:Graph 走訪
如果要問「朋友的朋友的朋友」這種 N 度關係,SQL 的 JOIN 每多一層關係就慢一截,因為它本來就不是為了走訪關係鏈設計的。
Graph Database 把使用者當節點(Node)、Follow 當邊(Edge),查詢時用 Graph Traversal 演算法(例如 BFS)沿著邊直接找下去,不需要像 SQL 那樣自己 JOIN 數次,層數增加對它的影響也小很多,適合拿來算「共同好友」「你可能認識的人」。
Consistent Hashing:Wide-Column Store 怎麼切
Cassandra、ScyllaDB 這類 Wide-Column Store,內部切分資料的方式叫 Consistent Hashing,概念上跟 Day 18 的 Hash-based Sharding 都是用到 Hash,但多做了一件事:把節點跟資料都映射到同一個雜湊環上,新增節點時只需要搬動環上相鄰的一小段資料,不像固定公式的 Hash Sharding,一改除數就要全部重新搬家。
Consistent Hashing 的環狀結構跟加減節點的運作方式,Day 21 會搭配圖解完整拆解;有興趣先自行了解的話,也可以參考 GeeksforGeeks 的內容。
完整架構長這樣
把資料庫分工跟演算法擺在一起,寫入與讀取的路徑大致是:
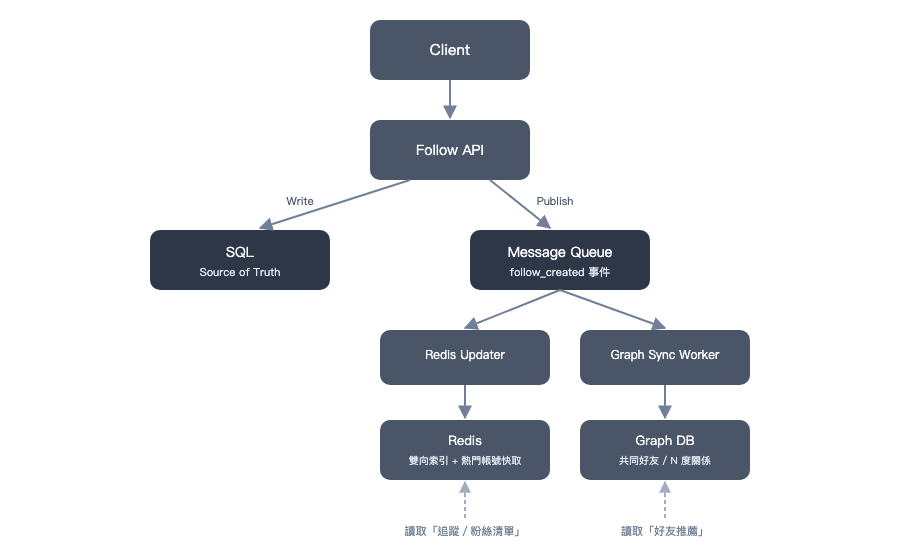
Follow / Unfollow 先寫進 SQL 確保正確,再發布事件到 Message Queue(Day 12 介紹的老朋友),由背景 Worker 分別同步到 Redis 跟 Graph Database。
之後的查詢,追蹤/粉絲清單找 Redis,好友推薦找 Graph Database,SQL 只在背景默默扮演 Source of Truth,不直接扛前線流量。
小結
Follow 表看起來只是一張關聯表,但撐到真實規模時,需要:
- SQL:Source of Truth,靠 Day 18 的 Sharding 撐住規模
- Redis:雙向索引解決 Scatter-Gather,Set 交集運算做共同好友
- Graph Database:非同步處理深度關係推薦
- Wide-Column Store:規模再大一個量級時的終極選項,內部用 Consistent Hashing 切分
而這份 Follow 資料,正是 Feed 在組裝內容時最先要查的東西——Day 3 那支最陽春的 Fan-out on Read Query,第一步就是靠它找出「這個人追蹤了誰」。當 Follow 關係本身變得又大又複雜,Feed 原本的做法還撐得住嗎?這是明天會討論的問題。
系列導覽
- 查看全系列:系統設計系列文總覽