系統設計系列文17:CAP Theorem - 你無法全都要

昨天討論 SQL 該不該換成 NoSQL,最後留下一個疑問,一旦資料開始分散在不同種類的 Storage 上,SQL、NoSQL、Cache 各存一部分。
怎麼確保各處看到的資料是一致的?
現在狀況只會比 Day 7 那種單純的 Primary/Replica 架構更複雜,其實這個問題在當時就已經埋下種子了。當時我們用 Database Replication 解決 Read Scaling:
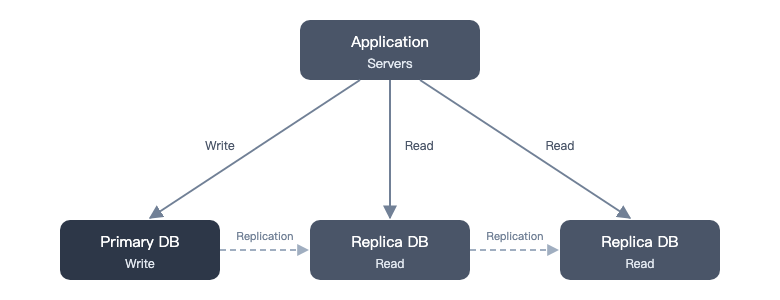
留下一個沒細講的伏筆——Replication Lag:Squirtle 剛發的文章,可能要過一小段時間才會出現在某些 Replica 上。
如果只是「晚一點看到自己剛發的文章」,問題還不算太嚴重。但如果今天不是 Replica 同步慢了半拍,而是 Primary 跟 Replica 之間的網路直接斷線呢?系統這時候該怎麼辦?
- 繼續讓部分節點提供服務,但資料可能不一致?
- 還是乾脆暫停服務,確保大家看到的資料都一樣?
不管是 Replica 之間、還是 SQL 與 NoSQL 之間,只要資料存在多個地方,就一定會遇到這個問題。這就是分散式系統裡一個非常經典的理論:CAP Theorem。
CAP Theorem 是什麼?
CAP 三個字母分別代表:
- Consistency:一致性
- Availability:可用性
- Partition Tolerance:分區容錯性
在深入定義之前,先看看它們實際上會遇到什麼情境。
Network Partition 是什麼
Network Partition(網路分區) 是指分散式系統中,因為網路故障或線路中斷,讓原本互通的節點變成互相聯絡不到的孤島,每座孤島內部仍能正常溝通,但孤島之間完全斷線。
假設我們有一組 Primary 和 Replica,平常靠網路持續同步:
Primary
   │ Replication
   ↓
Replica
某天網路出狀況,兩台機器本身都還活著、Process 也沒有 Crash,但彼此聽不到對方。這時候如果有一筆 Write 進來:
Set balance = 80
如果我們讓其中一個節點照樣接受這筆寫入,另一個節點卻不知道這件事,就可能變成:
Node A
balance = 80

Node B
balance = 100
兩邊資料兜不起來,這就是 Consistency 被犧牲的情況。
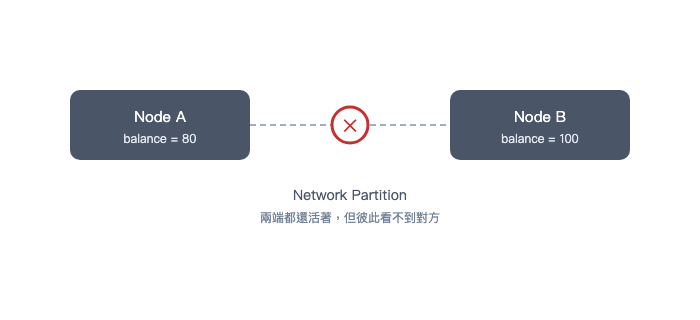
但如果反過來,為了避免資料不一致,我們讓系統在偵測到節點失聯時直接拒絕所有 Request,資料是保持一致了,可是系統變得不能用,這又變成犧牲了 Availability。
C:Consistency
在 CAP 的脈絡下,Consistency 指的是不論用戶端連到哪個節點,看到的資料都要一致,不會因為連線到不同節點而得到互相矛盾的答案。
舉個例子:Pikachu 原本的暱稱是「黃色老鼠」,他把暱稱改成「皮神」。如果修改成功後,下一次讀取卻從另一個節點看到「黃色老鼠」,Pikachu 大概會懷疑自己剛才是不是根本沒改成功。
A:Availability
Availability 指的是只要有 Request 進來,系統就要給出回應,不會因為某個節點掛掉或網路異常,就整個拒絕服務。
P:Partition Tolerance
Partition Tolerance 指的是即使節點之間發生網路分區、彼此失聯,整個系統仍然要能繼續運作。
CAP 三選二?
CAP 理論常被簡化成「三選二」,但實務上網路本來就不可靠,斷線遲早會發生,Partition Tolerance 幾乎是不能放棄的前提,所以真正要取捨的其實只剩下:發生分區的當下,要選擇 Consistency,還是選擇 Availability? 也就是常聽到的 CP 或 AP。
Consistency 模式
再往下一層討論,「一致性」本身不是非黑即白,常見的幾種模式:
Strong Consistency(強一致性)
資料寫入後,任何後續的 Read 都能立刻看到最新結果,所有副本以同步方式更新。這種模式適合金融交易這類必須保證資料正確的場景。
假設 Pikachu 從帳戶轉帳給 Charmander,這筆異動要立刻反映到所有節點,不能讓 Charmander 在別的地方查詢時,看到轉帳前的舊餘額。
Weak Consistency(弱一致性)
資料寫入後,不保證後續 Read 一定能看到最新結果,取決於當下請求打到哪個節點。這種模式犧牲了確定性,換取更好的 Availability 與低延遲。
即時通訊、多人連線遊戲常常屬於這一類,通話斷了幾秒鐘,畫面或聲音短暫消失,但通話還在繼續,遺失的那幾秒資料通常也不會再補回來。
Eventual Consistency(最終一致性)
資料寫入後不保證馬上同步,但保證最終所有節點都會拿到同一份結果,可以視為一種 Weak Consistency 延伸的類型。
社群平台的 Like Count 就是典型例子。Charmander 對某篇貼文按讚後看到 11 個讚,Squirtle 同一時間打開卻還顯示 10 個讚,多數人不會太在意這種短暫落差,而這個數字最終會同步到所有節點上。
當 Primary 掛掉了
CAP 不是只有網路分區這一種情境,Primary 節點直接故障也是分散式資料庫必須面對的現實,而它的處理方式正好體現了 CAP 的取捨。
假設某天 Primary 因為硬體問題直接掛掉:
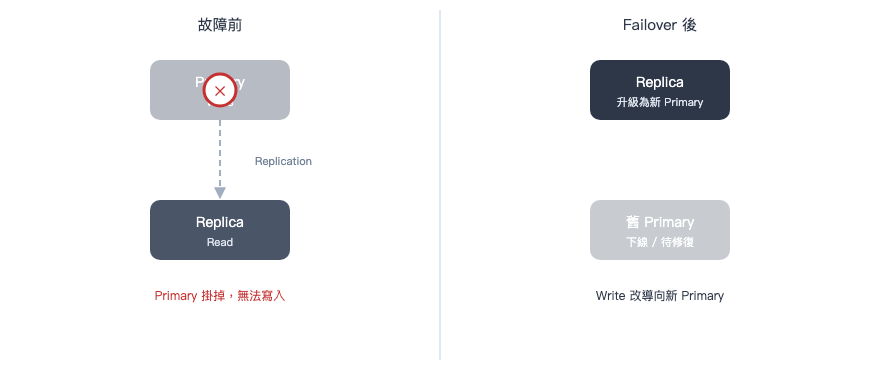
系統通常會執行 Failover(故障轉移),從現有的 Replica 中挑一個,把它升級成新的 Primary,讓寫入可以繼續進行。這個過程大致是:
- 偵測 Primary 沒有回應(Health Check 連續失敗)
- 從 Replica 中選出一個資料最新的節點
- 把該 Replica 升級為新 Primary
- 讓 Application Server 改把 Write 導向新 Primary
- 原本的 Primary 修復後,降級成 Replica 重新加入
聽起來很簡單,但魔鬼藏在細節裡:
如果被選中升級的 Replica,資料其實還沒完全同步完呢? 那些「Primary 已經寫入,但還沒同步到這個 Replica」的資料,就可能在升級的瞬間憑空消失,這是 Failover 過程中一種常見的資料遺失風險。
如果切換的當下,Application Server 還沒反應過來,繼續把 Write 送到舊 Primary 呢? 在偵測到故障、完成升級之前,一定會有一段「不知道該把 Write 送去哪」的空窗期,這段期間系統要嘛拒絕寫入(犧牲 Availability),要嘛冒著資料衝突的風險繼續寫(犧牲 Consistency)。
這也是 CAP 理論在真實系統裡的具體情形:
沒有一個 Failover 機制可以同時保證「零資料遺失」又「零服務中斷」
工程團隊只能根據業務需求,決定寧可短暫不可用、還是接受極小機率的資料遺失。
Availability 模式
Active-Passive:候補等接手
剛才那個 Failover 流程,其實有個更廣義的名字:Active-Passive,對應的正是 Day 7 提過的 Primary-Replica 架構。
在這種模式下,只有 Active(也就是 Primary)真正處理流量,Passive(Replica)平常待命,兩邊靠定期互傳的 Heartbeat(心跳) 確認對方還活著。一旦 Heartbeat 中斷太久,Passive 就會接手,變成新的 Active。
這裡有個常被忽略的細節,Passive 待命的方式分兩種,會直接影響切換要花多久:
- Hot Standby:Passive 已經啟動、資料也持續同步,故障當下幾乎能立刻接手
- Cold Standby:Passive 平常沒有真正跑起來,要先啟動、載入資料才能開始服務,切換時間明顯拉長
前面「Primary 掛掉了」的案例,用 Replica 頂替 Primary,正是一種 Hot Standby 的 Active-Passive Failover。
Active-Active:兩邊都在做事
另一種模式是 Active-Active:兩個節點同時處理流量,沒有誰是備胎。
Client
  ├──→ Node A(Active)
  └──→ Node B(Active)
如果是對外服務,DNS 要同時知道兩個節點的位址;如果是內部服務,則換成 Application 自己要知道兩邊都能打。
這正好對應到 Day 7 提過的 Multi-Primary Replication,因為兩邊本來就都在接受寫入,其中一邊掛掉時,另一邊不需要經歷「升級成新 Primary」這個步驟,可以直接繼續服務,沒有 Failover 那幾秒到幾分鐘的空窗期。
代價也講過了,兩邊都能寫就得面對 Write Conflict,這是 Active-Active 用「更快的容錯」換來的複雜性。
Failover 逃不掉的兩個成本
不管是 Active-Passive 還是 Active-Active,Failover 機制都有兩件事省不掉:
- 多硬體就更複雜:不管是讓 Passive 待命,還是讓兩邊都處理流量,都代表要多準備、多維護一套系統
- 資料遺失的風險:如果 Active 掛掉的那一刻,還有資料來不及同步到另一邊,這筆資料就可能永遠消失
用 PokeThreads 來看 CAP
回到我們正在做的 PokeThreads,不同資料其實適合不同程度的一致性:
可以接受短暫不同步:
- Like Count
- View Count
- Follower Count
需要強一致性:
- Account Status
- Permission
- Authentication State
如果一個帳號已經被停權,卻因為節點沒同步而讓某些 Server 仍認為它是正常帳號,這種不一致造成的後果就嚴重多了。
所以 CAP 從來不是「整個系統只能選一邊」,而是針對不同種類的資料,做出不同的取捨:
- 使用者資料、身份驗證 → 偏向強一致性,Failover 時寧可短暫拒絕寫入
- Feed、Like Count → 可以接受最終一致性,Failover 時優先維持服務可用
那為什麼不是一開始就討論 CAP?
因為在只有一台 Database 的時代,根本沒有「不同節點看到不同資料」這種問題。而當我們開始做 Replication,資料分散到多個節點,Network Partition、Replication Lag、Consistency 這些議題才真正浮現。
小結
今天把 Day 7 留下的 Replication Lag,延伸成完整的 CAP Theorem:
- 分散式系統必須接受 Partition Tolerance 是不能放棄的前提
- 真正的取捨在於發生分區時,要選 Consistency 還是 Availability
- Primary Failover 是 CAP 取捨在真實系統裡最具體的體現
- 沒有機制能同時保證零資料遺失與零服務中斷
- Failover 也有 Active-Passive、Active-Active 兩種模式
- 分別對應 Primary-Replica 與 Multi-Primary:一個簡單但要等切換,一個沒有空窗期但要處理 Conflict
CAP 看起來很理論,但它會實際影響我們之後每一個「要不要引入新節點、新複本」的決定,這條線會一路貫穿到後面 Sharding、Counter System 這些主題裡。
系列導覽
- 查看全系列:系統設計系列文總覽